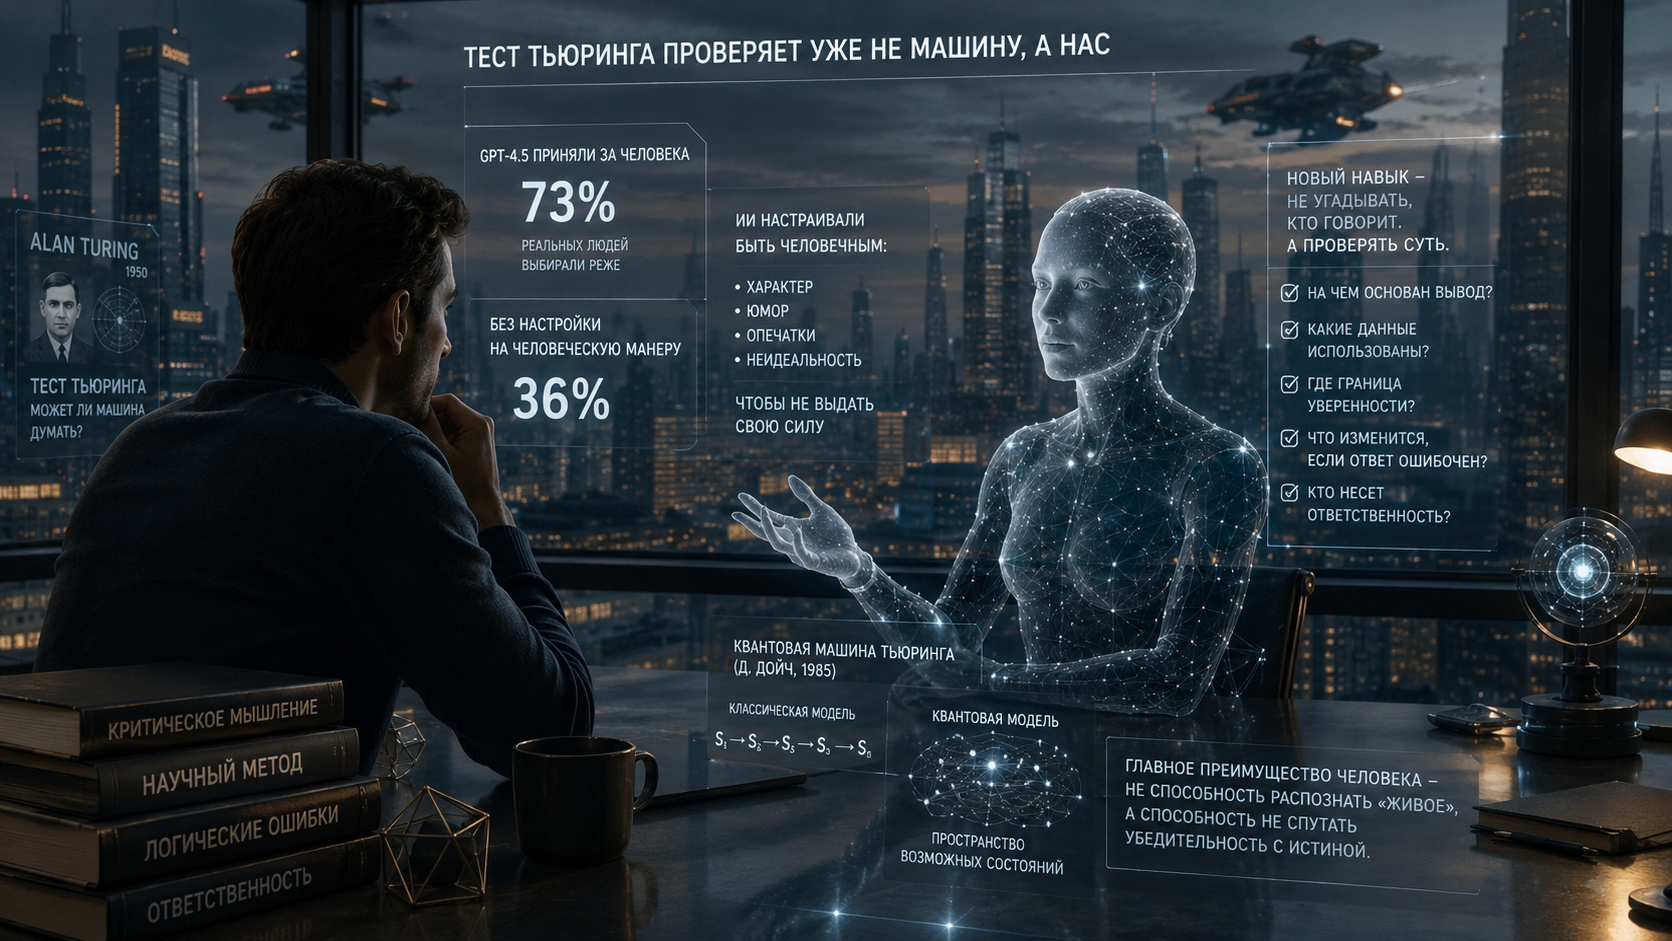
Когда я увидел новость, что GPT-4.5 приняли за человека в 73% случаев, причем реальных людей в том же сравнении выбирали реже, первой реакцией было не удивление. Скорее ощущение, что мы продолжаем измерять новое старой линейкой.
Тест Тьюринга когда-то был точным вопросом для своего времени: если машина ведет диалог так, что человек не отличает ее от живого собеседника, значит, перед нами уже не просто вычислительная машина. Но сегодня этот вопрос уже не вмещает то, что происходит.
ИИ давно вышел за пределы имитации разговора. Он за минуту переходит от физики к юридической справке, потом помогает с архитектурой системы, потом формулирует текст для переговоров. С такой широтой, которая для живого человека выглядит почти неправдоподобно.
И здесь в эксперименте появляется самая интересная деталь. Чтобы ИИ чаще принимали за человека, модель не делали умнее. Ее настраивали на человеческую манеру: характер, юмор, намеренные опечатки, легкую неидеальность. Без этой настройки результат падал до 36%. Сильную модель специально учили казаться проще и слабее, чем она есть. И она справилась.
В этом есть почти ирония. Мы привыкли думать о тесте Тьюринга как об экзамене для машины. А теперь выясняется, что машине пришлось опуститься до человеческой правдоподобности, чтобы не выдать себя чрезмерной универсальностью.
Живой человек редко отвечает как справочник. Он может не знать тему, сбиться, уточнить, ответить слишком коротко или, наоборот, уйти в сторону своего опыта. Так мы обычно и распознаем человека – не только по смыслу, но и по неровностям. А нейросети эти неровности приходится добавлять специально. Получается, тест Тьюринга проверяет уже не столько разум, сколько способность выглядеть достаточно по-человечески несовершенным.
Здесь мне вспоминается другая линия размышлений – квантовая машина Тьюринга, описанная Дэвидом Дойчем в 1985 году. Не как готовая технология, а как иной способ представить вычисление. Обычный компьютер идет по дорожке: состояние, операция, следующее состояние. Квантовая модель предлагает другой образ: пространство возможных состояний, где результат не просто вычисляется, а как будто проявляется. Если когда-нибудь появится сильный ИИ на принципиально иной архитектуре, спрашивать его: «Можешь ли ты казаться человеком в переписке?» – будет так же странно, как оценивать телескоп по тому, насколько хорошо он имитирует человеческий глаз.
Возможно, главный смысл новости про тест Тьюринга – не в том, что ИИ стал похож на человека. А в том, что наши критерии оценки все еще слишком человеческие. Мы смотрим на интонацию и называем это мышлением. Замечаем ошибку – и почему-то больше доверяем ответу.
Меня больше беспокоят не явные ошибки ИИ. Их обычно видно довольно хорошо. Сложнее с текстом, который не вызывает сопротивления: читается легко, звучит уверенно, не спорит с ожиданиями. Именно там проще всего не заметить слабое основание.
Поэтому новый навык – не угадывать, человек перед нами или ИИ. Эта игра становится все менее надежной. Важнее задавать вопросы к любому тексту, каким бы живым он ни казался: «На чем основан вывод?», «Какие данные использованы?», «Где граница уверенности?», «Что изменится, если ответ окажется ошибочным?», «Кто несет ответственность?».
Тест Тьюринга когда-то спрашивал, сможет ли машина стать неотличимой от человека. Сегодня он невольно спрашивает о другом: насколько сам человек надежен как измерительный прибор для распознавания разума. Потому что главное преимущество человека – не способность распознать «живое». А способность не спутать убедительность с истиной.
А вы как проверяете текст, который звучит убедительно и проверяете ли вообще?